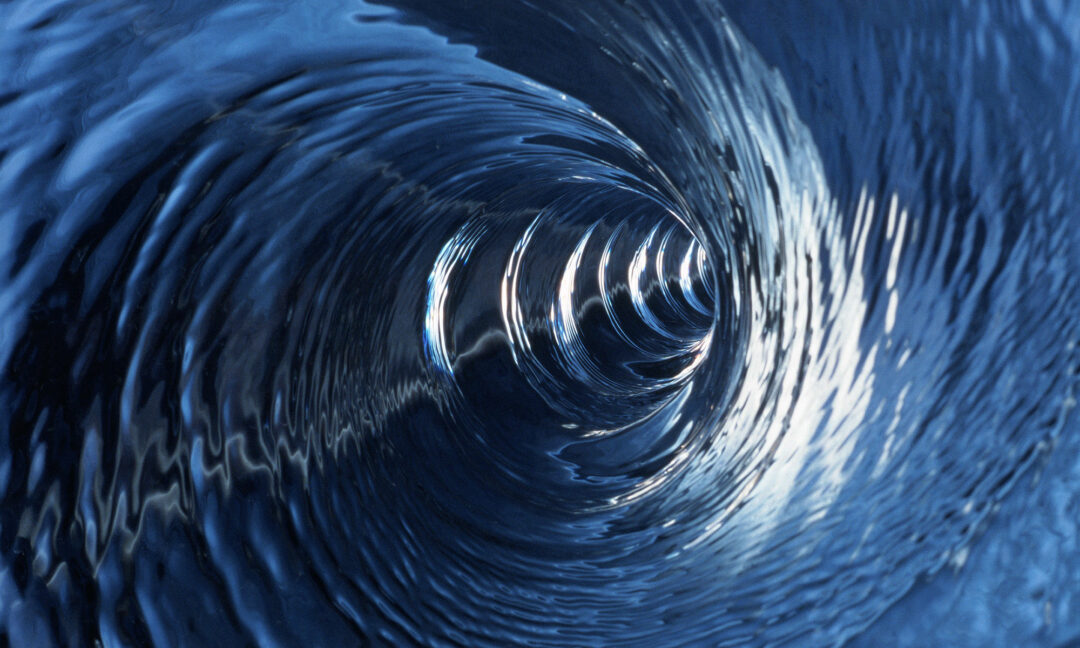
Navier–Stokes-ekvationerna beskriver hur vätskor och gaser rör sig – till exempel hur virvlar bildas och utvecklas i vatten.
Bild: Getty images
Kontroverserna som kantar Open AI:s genombrott i matte
Open AI:s lösning av Navier-Stokes-problemet visar hur AI-språkmodeller kan bidra till matematiska genombrott trots sina logiska misstag. Men lösningen har mött kritik och invändningar från flera håll. AI-forskaren Moa Johansson reder ut vad vi vet och inte vet om hur lösningen kom till.
Nyligen gick det amerikanska företaget Open AI ut med att man hade löst ett av de så kallade Millennieproblemen, Navier-Stokes, med hjälp av AI. Millennieproblemen valdes ut år 2000 som särskilt svåra matematiska utmaningar för det nya århundradet, var och en med ett pris på en miljon dollar till den som löser dem.
Navier-Stokes är en serie ekvationer som beskriver hur gaser eller vätskor rör sig. Millennieproblemet handlar om huruvida ekvationerna alltid följer fysikens lagar eller ej. Det Open AI har bevisat är att ekvationerna under vissa omständigheter beskriver en virvel med oändlig hastighet – en fysikalisk omöjlighet. Alltså är det nu fastställt att ekvationerna åtminstone inte är kompletta, om än inte nödvändigtvis felaktiga.
Hallucinerande språkmodell får hjälp av bevisassistent
Det nya AI-beviset är det senast i raden av resultat inom matematik som fått stor uppmärksamhet. I våras använde samma företag en stor språkmodell för att lösa ett problem formulerat av matematikern Paul Erdős för 80 år sedan.
Navier-Stokes anses dock vara av högre kaliber i svårighetsgrad och AI-metoderna skiljer sig åt något. Open AI har publicerat ett pressmeddelande och en rapport med beviset för Navier-Stokes problemet, men inga djupare detaljer om själva metoden är kända eller granskade av oberoende parter. Den här texten är ett försök att ändå reda ut vad vi vet och inte vet om hur det hela gick till.
För Navier-Stokes användes först och främst en ny intern språkmodell som inte är tillgänglig för Open AI:s kunder. Ett stort antal instanser av denna modell – agenter – grupperades för att samarbeta på olika varianter av problemet, och de mest lovande resultaten delades sedan vidare till andra grupper av agenter för fortsatt arbete. Språkmodellerna ansvarar alltså för att generera förslag på bevissteg, men som för alla neurala nätverk kan det hända att misstag i form av ”hallucinationer” slinker igenom.
Därför kompletterades språkmodellerna med en så kallad bevisassistent som använder symbolisk logik för att steg för steg kontrollera att det inte finns några logiska hål i resonemanget. Denna typ av system, som kombinerar neurala nätverk med symbolisk logik, kallas ibland neuro-symbolisk AI.
Liknande systemarkitekturer har använts för många av de uppmärksammade resultaten inom AI och matematik de senaste åren, exempelvis Deepminds Alphaproof, som nådde silvermedaljsnivå i internationella matematikolympiaden 2024.
Tusentals AI-agenter samarbetade
Det slutgiltiga Navier-Stokes-beviset hittades av en grupp med 10 000 agenter efter 88 timmar. Agenterna skickade totalt 2,7 miljoner meddelanden mellan sig, vilket krävde cirka 130 miljarder output-tokens (en token kan jämföras med en stavelse eller del av ett ord).
Open AI har inte offentliggjort hur många agenter och hur mycket beräkningskraft som använts totalt för att hitta lösningen, men den sammanlagda kostnaden ska ha uppgått till ungefär en miljon dollar. Forskaren Karthik Duraisamy vid University of Michigan, uppskattar dock motsvarande kostnad om en kund skulle ha anlitat Open AI till mellan sex och tio miljoner dollar.
Karthik Duraisamy bedömer också att det hela har krävt omkring 400 000 timmars användning av mycket dyra grafikkort. Att beviset hittades på relativt kort tid ska alltså ses i ljuset av hur mycket parallell beräkningskraft som använts – kanske är även detta ett rekord. Att bevisa ett Millennieproblem med hjälp av AI är alltså inget man gör som hobbyprojekt!
Open AI har inte heller uppgett något om hur den mänskliga arbetsinsatsen i projektet såg ut: hur agenterna promptats, hur man valt vilka agentgrupper som ska arbeta med vad, och hur mycket och vilken översyn Open AI:s matematiker lagt på agenterna. Man har heller inte offentliggjort vilken träningsdata som använts, eller information om eventuella tidigare misslyckade försök på detta och andra Millennieproblem.
Stöld eller sammanträffande?
Open AI började arbeta på problemet efter att man hört ryktas att just Anthropic, deras största konkurrent, skulle vara nära att lösa ett av Millennieproblemen. Strax innan Open AI annonserade sitt bevis dök det upp en text av matematikern Tristan Buckmaster, som arbetat på just Navier-Stokes tillsammans med den Anthropic-anställde matematikern Levent Alpöge.
Buckmaster skrev att Open AI hade satt press på honom att publicera utan Alpöge, och ställde frågan om huruvida Open AI kan ha fått nys om deras arbete via chatloggar i Open AI:s Chat GPT som de använt i sitt arbete, samt ifall deras data kan ha använts som träningsdata i de nyaste modellerna. Open AI dementerade detta.
AI-bolagen har också kritiserats för att lägga sina oerhört stora resurser på problem där man vet att en lösning varit nära, för att svepa in och stjäla priset framför näsan på akademiska forskare som ofta ägnat lång tid att bygga upp grunderna. Exempelvis ansågs just Navier-Stokes vara det av Millennieproblemen som var närmast en lösning efter att de spanska matematikerna Diego Córdoba och Luis Martínez-Zoroa under lång tid lagt viktiga grunder, som Buckmaster och Alpöge sedan tillämpat.
Lösningens relevans ifrågasätts
Ett antal högprofilerade matematiker har också påpekat att det inte heller är givet att ett AI-genererat bevis leder till vetenskapliga framsteg i förståelse och teoribyggande utan kanske tvärtom minskar incitamenten att göra det grundläggande arbete som krävs. Ytterligare en kritik som förts fram är att Open AI löst en version av Navier-Stokes som förlitar sig på en formulering som inkluderar en extern kraft, vilket inte är realistiskt i verkligheten.
Kommer vi nu att se de kvarvarande Millennieproblemen lösta inom kort? Det beror nog på om de nödvändiga grunderna finns och om företagen tycker att det är värt att lägga ännu mer pengar ur PR-budgeten på just detta. För akademiska forskare utanför de stora techföretagen är frågan också hur långt den beräkningskapacitet och de modeller som vanliga kunder kan få tillgång till räcker.
Det verkar dock tydligt att både stora språkmodeller och bevisassistenter kommer att bli viktiga verktyg inom matematiken framöver. Men kanske även i form av öppna språkmodeller som kan köras lokalt, vilket för oss europeiska forskare även knyter an till aktuella frågor om digital suveränitet och digitalt oberoende från stora techbolag i utlandet.
Moa Johansson
- Professor i artificiell intelligens vid Chalmers tekniska högskola.
- Forskar om neuro-symbolisk AI.
- Arbetar särskilt med AI för matematik, automatiserad bevisföring och maskininlärning.
Läs mer

AI-genombrott kan försämra förståelsen för matematik
Forskningen riskerar att bli sämre om AI används fel.
En av världens snabbaste datorer invigs i Linköping
Superdatorn Arrhenius ingår i en europeisk satsning på att bli mer självförsörjande inom AI.

Forskare utvecklar nya virus med AI
De nya virusen är riktade mot bakterier och kunde döda E. coli i experiment. Men tekniken innebär även risker.
Nobelpristagaren, Deepmind och jakten på superintelligens
I The infinity machine får vi möta en av AI-utvecklingens mest kända profiler.
Fem faktorer avgör när det är okej att använda AI
Vi låter gärna AI avslöja bankbedrägerier, men tvekar inför att låta den döma brottslingar eller fatta beslut om vapen.